在此页面上
一位研究人员在审查会议后正在修改方法部分。团队的证据分散在论文库、会议记录、草稿文档以及关于为何排除一项分析的电子邮件线程中。眼前的请求听起来很谦虚:解释当前的纳入标准并确定哪些决策仍需要来源。
通用AI可以帮助完成这项任务。但如果没有历史记录,第一个任务通常是重建历史记录。研究人员搜索相关笔记,将段落复制到聊天中,解释哪个草稿是当前的,并警告助手不要将旧计划视为最终协议。
问题主要不是模型散文的质量。而是每次要求模型贡献时,重建项目工作图的成本。
之前:对话从重建开始
想象一下,审查会议以三个决定结束。团队保留了一个纳入标准,缩小了另一个,并推迟了第三个,等待额外的检查。这些决定存在于不同的地方:议程说明了提议的内容,会议记录说明了达成一致的内容,最新草案显示了实际更改的内容。
研究员要求助手写一份简短的摘要。它对提供的摘录做出了合理的响应。然而,一个遗漏的注释可能会改变结论。一段精美的段落仍然可以描述昨天的计划。
为了防止这种情况,研究人员成为了检索系统:打开标签页,选择段落,澄清时间顺序,并检查答案是否悄悄地将提案与决定混为一谈。当工作从聊天助手转向写作或编码工具时,解释必须重复。
这是无状态工作流常见的结构性弱点,而不是假设助手可以推断缺失事实的理由。如果证据从未提供,流利的回答并不能使其存在。
之后:工作点提供上下文
在这种情况下,研究人员连接受支持的来源并授权一个 AI 集成来检索相关信息。上下文系统维护项目关系:哪个草稿属于哪个研究,哪个会议先于修订,以及哪条消息包含排除的理由。
研究员问道:“起草当前的纳入标准,并告诉我每个更改的来源。标记任何仍然不确定的内容。”
助手没有粘贴大量档案,而是请求活动研究允许的上下文和源链接。讨论从当前的决定及其背后的证据开始。
一个好的回应会区分商定的标准和提议的标准,引用记录该决定的会议记录,并标记未解决的检查。研究人员随后会在接受措辞之前打开原始来源。如果电子邮件和草稿冲突,答案应该揭示冲突,而不是选择看起来更新的文本。
助手尚未成为该研究的权威。它已更好地定位,以帮助研究人员检查已收集的证据。
工作流程一览
| 没有共享上下文 | 与选定的项目上下文 |
|---|---|
| 查找会议记录 → 复制摘录 → 解释之前的决定 → 请求综合 | 授权相关来源 → 检索项目上下文 → 起草并附带来源链接 → 验证声明 |
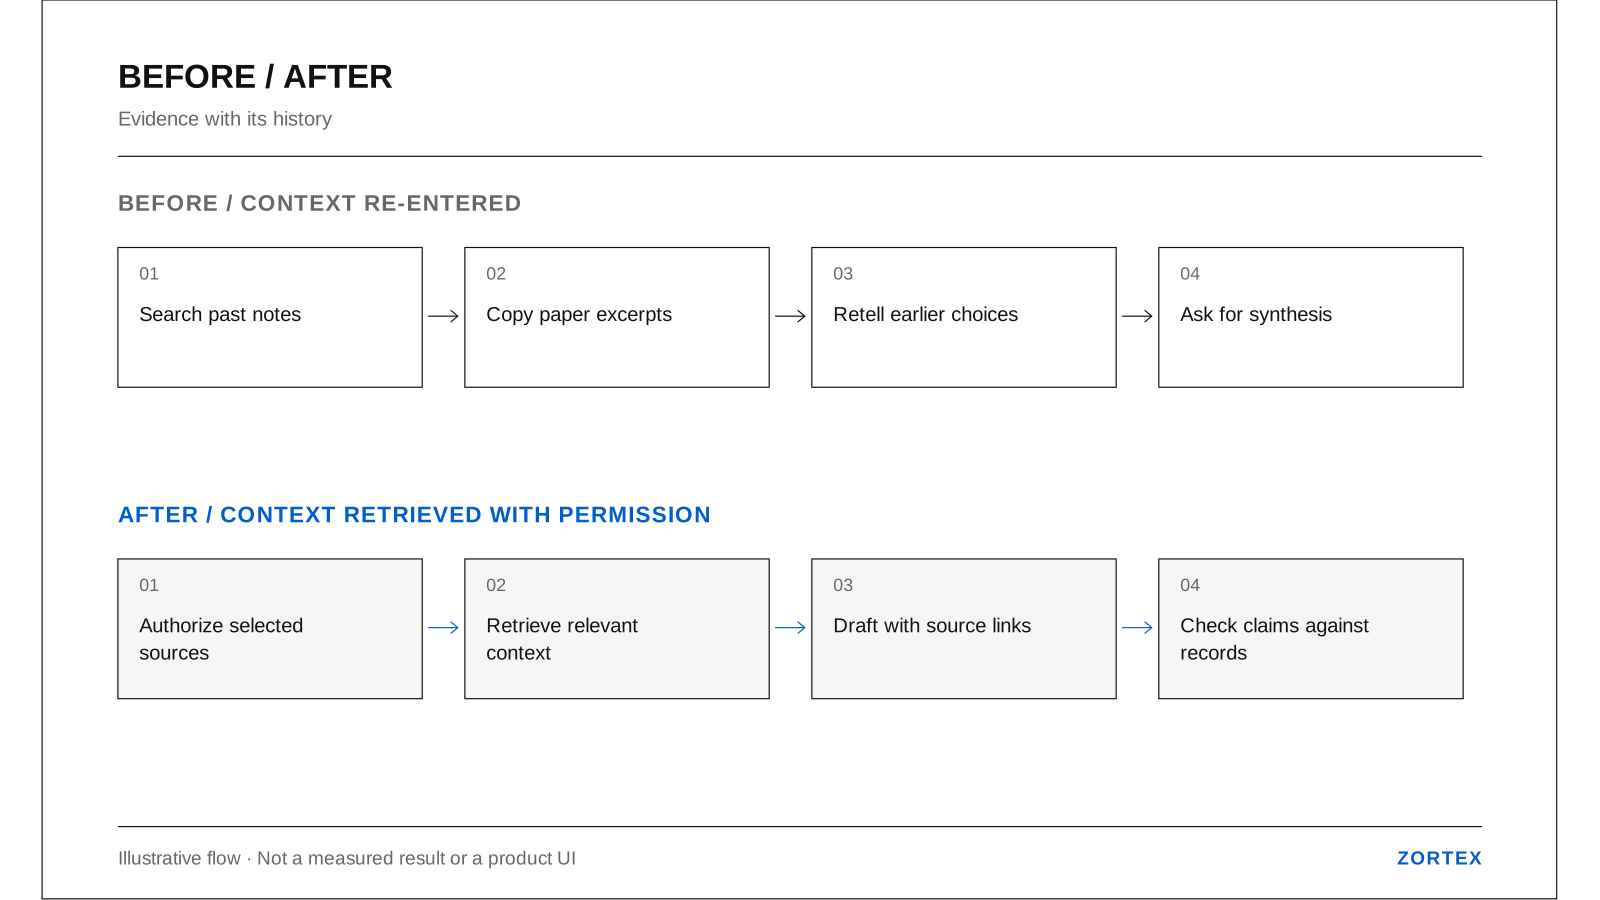
相同的方法问题,带有手动和源链接的上下文收集。
实际改变了什么
第一个区别在于努力的方向。在早期的工作流程中,研究人员将注意力集中在为模型组装输入上。在上下文工作流程中,更多的注意力可以用于判断模型是否选择了正确的证据并正确解释了它。
第二个是工具间的连续性。同一个项目历史可以为关于方法论的聊天讨论和之后关于数据集的编码问题提供信息,前提是每个集成都具有必要的权限。它不应该要求将整个对话历史从一个助手复制到下一个。
第三是保留粘贴摘要经常丢失的区分的能力。一个项目有临时建议、已批准的决定、已放弃的实验和待解决的问题。将这些视为不同类型的信息比生成更长的项目记忆更重要。
所有这些都不能保证正确的答案。检索系统可能会遗漏文档,笔记可能出错,两位协作者可能对会议决议存在分歧。来源链接是检查的手段,而不是检查的替代品。无法找到证据的助手应该说明,而不是悄悄地填补空白。
边界所在之处
工作流程取决于研究人员选择连接的来源以及所选AI的能力和授权。不在这些来源之外的文件不应仅仅因为相关而出现。帮助撰写方法摘要的授权并非发送消息、编辑协议或发布私人研究信息的许可。
本地优先存储也不意味着每个AI请求都停留在本地。如果连接的助手在云提供商上运行,则返回给该助手的选定上下文可能会由提供商处理。研究人员在使用机密或未发布材料之前需要了解该边界。连接源、授予AI访问权限和批准操作是独立的决策。
Zortex Version 2 为授权的 AI 工具组织上下文。 版本2页面 列出了访问和支持的连接要求。该帐户使用该架构遵循一个方法修订任务。
衡量成功的标准
有用的检查是来源可追溯性:研究人员能否在不重建项目的情况下找到原始记录、识别未解决的决策并纠正错误?
重要的时刻在草稿到达之后:研究人员识别来源,纠正限定词,然后回到方法部分。AI提供对工作证据的访问;它不做出方法论决策。