在此页面上
如果个人上下文引擎可以在本地处理工作数据,则更容易信任它。但本地处理是有代价的:时间、内存、电池使用、存储写入以及与个人已运行的应用程序的竞争。短语 本地优先 没有告诉我们实施的成本是多少。
我们测量了一个 Python 例程从生成的记录中构建关键字帖子和人员-项目边缘所需的时间。它将一个小的 CPU 索引操作与提供商摄取、嵌入和后台同步分开。
执行环境: 2026年10月9日,Python 在记录的 Linux 执行容器中。时间样本和机器详细信息保留在 raw.json 中。
问题
在固定生成工作负载中,随着记录数量的增长,一次本地 Python 索引通过的中间时间如何变化?在重复测试中,测量时间的范围是多少,以及在启用跟踪时可见的 Python 峰值分配量是多少?
我们在原始输出中报告了进程环境,因此结果不会被误认为是跨设备性能保证。计时尤其取决于运行时、操作系统、进程调度和并发负载。单个基准测试机器无法建立其他机器上的用户体验。
设置
夹具生成器创建了三个独立的集合,分别包含250、1,500和6,000条工作记录。每条记录都有一个项目ID、一个人员ID和一个由固定词汇中抽取的36个标记组成的正文。这些值并非取自邮件、日历、Slack、源代码或个人文件。
对于每个集合,索引函数对正文进行分词,记录每个不同词元的文档发布,并添加一个 (project, person) 与集合的关系。它返回唯一令牌、关系边和发布条目的计数。我们丢弃一次预热调用,然后使用七个顺序构建进行计时 perf_counter_ns。基准排除了计时区域中的夹具生成。
Python 的 tracemalloc 在七次测量迭代中保持启用,并记录峰值跟踪分配。该仪器增加了开销,因此这些数字并非优化实现的下限。我们选择普通的 Python 实现正是因为其操作易于检查,而不是因为它类似于产品的生产索引管道。
该代码生成每次试验的时间、中位数、最小值、最大值和工作负载计数器。输出是对真实脚本执行的测量,而不是计算出的复杂性预测。
结果
| 生成的记录 | 中位构建时间 | 7 次试验的范围 | 峰值追踪分配 |
|---|---|---|---|
| 250 | 7.0415 毫秒 | 6.8651–7.6815 毫秒 | 55.3 KiB |
| 1,500 | 44.2987 毫秒 | 40.4529–49.5353 毫秒 | 403.8 KiB |
| 6,000 | 174.8375 毫秒 | 171.4043–214.0025 毫秒 | 1,990.7 千字节 |
以下是测量中位数的文本图。每个条形图使用相同的比例,最长的代表6,000条记录的测量值。
  250 records | █                      7.0 ms
1,500 records | ██████                44.3 ms
6,000 records | ███████████████████████ 174.8 ms
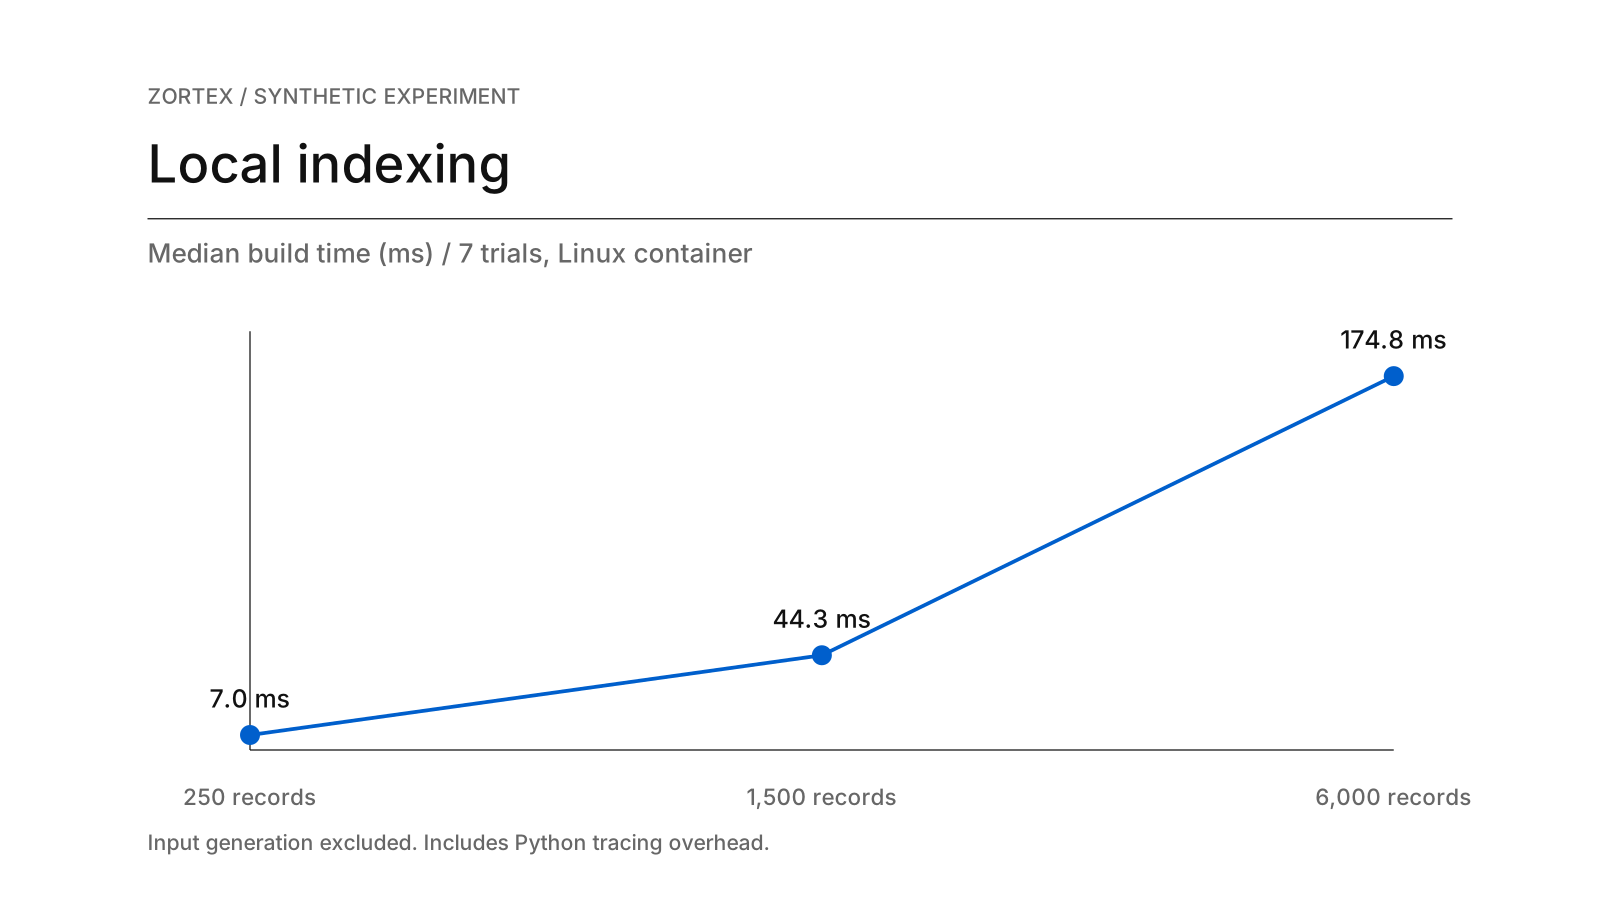
在每个生成的记录计数下,七次仪器化通过的中位构建时间。
在这些工作负载中,中位时间随着输入的增长而增加。观察到的数字并非线性扩展的证明;只有三种大小,并且词汇量故意很小。在 6,000 条记录中,七次试验中有一次明显慢于中位数。这种差异是为什么单一的标题持续时间会是一个糟糕的操作合同。
峰值分配列也容易被误解。 tracemalloc 测量Python跟踪的分配,而不是总驻留进程内存。它省略了部分本机库内存、解释器的基线占用、操作系统缓存、存储使用以及真实连接器可能生成的任何进程。将这些值视为此功能的调试遥测,而不是桌面应用程序所需RAM的估计。
测量结果表明了什么
第一个设计教训是建立时间边界。通过网络读取邮箱、解析MIME、规范化身份、存储加密记录和生成嵌入是具有不同性能特征的不同阶段。本地优先系统应分别测量初始导入、增量更新、查询时间和后台协调。将它们合并为一个数字将使回归难以定位。
第二个教训是衡量避免的工作量。玩具函数每次都重建整个索引。一个真实的系统应该评估是否可以跳过未更改的记录,以及是否可以在不扫描整个语料库的情况下提交小的连接器更新。这可能比优化紧密的标记化循环对感知性能更重要。
第三是为用户的机器而非仅仅是进程的最佳情况进行预算。在空闲开发容器上看起来很短的后台任务仍然可能中断调用、编译或视频播放。有用的工程阈值必须包括持续负载、能源影响和取消行为。
测量范围
定时代码是一个Python发布列表和关系边缘构建器,独立于桌面应用程序及其SQLite Vault。该夹具具有重复的令牌、统一的记录长度、无二进制附件且无跨应用程序解析。它在计时开始前适合内存。测量是在带有Python的Linux容器中进行的;它们不是macOS或Windows结果。
每个输入大小都有七次测量通过和报告的最小-最大范围。内存是跟踪分配,而不是常驻集大小。文件 I/O、加密、电池条件和同步争用不在范围内。生成的记录保护私人工作数据,同时使计时输入可重现;它们的词汇和长度是统一的。
从完全重建到增量更新
使用增量索引、更大的词汇表、混合文档大小和模拟编辑重复此测试。在支持的桌面操作系统上进行基准测试,记录进程RSS和磁盘写入,并在另一个CPU密集型应用程序活动时收集计时分布。只有这样才能为初始导入、每次更新工作和最大后台资源使用设置产品级预算。
确切的脚本是 experiments/local-indexing/run.py。其 raw.json 包含每个大小的全部七个计时样本、工作负载计数器、执行平台信息以及此处绘制的值。保存的计时样本使跨重新运行和运行时环境的变化可见。