在此页面上
一个网络可以将权重存储为单个位而不是32位浮点数。这表明模型更小,内存流量更少,推理可能更快。最后一部分不是自动的。当我们对手写数字训练部分二值神经网络时,其准确性几乎没有变化,并且其 计算的打包张量有效载荷 小得多。但我们实际的 CPU 推理速度比全精度模型慢。
一位矩阵仅在运行时可以使用其表示时才有用。将影子权重存储或乘以浮点值可能会消除预期的优势。
一个刻意的小比较
我们使用了相同的公开打包的 scikit-learn 数字数据集 作为我们的对抗性鲁棒性实验:1,797 张灰度图像,每张 8 × 8,属于十个类别。像素值除以 16。我们进行了固定的分层分割,分为 1,347 张训练图像和 450 张保留图像 使用种子 2609。这是一个分类练习,不代表个人用户数据。
两个网络都有层宽度 64 → 256 → 256 → 10 并在线性层之间进行批量归一化。他们使用 Adam 以 0.0015 的学习率、128 的批量大小和相同的种子迷你批量顺序训练 80 个 epoch。基线使用普通的浮点线性层和 ReLU 激活。
二进制变体是故意 部分,而不是端到端的一位网络。它保留了一个浮点输入投影、一个浮点输出分类器、偏差和归一化参数。它的中间层 256 × 256 权重矩阵在前向传播中二值化为 -1 或 +1。该中间矩阵的输入激活也二值化为 -1 或 +1。在二值激活之前,第一个归一化输出保持有符号;应用符号 之后 ReLU 会将每个非负输入折叠为 +1 并破坏信息。
训练使用直通估计器:前向传播使用符号函数,而后向传播通过幅度至多为一的值传递梯度。底层权重仍是用于优化的浮点参数。这遵循了在以下方面探索的实用思想 二值化神经网络,而无需重现该工作的完整架构或自定义位执行内核。
我们选择这个中间矩阵是因为它解释了 86,026 个可训练参数中的 65,536 个。将一个微小的最终分类器二值化对大小的说明很少。然而,将两个外层保持全精度也意味着我们不能声称完全二进制的推理图。
三次测量,三个不同的答案
| 指标 | 全精度 | 部分二进制 |
|---|---|---|
| 纠正保留的数字 | 443 / 450 | 442 / 450 |
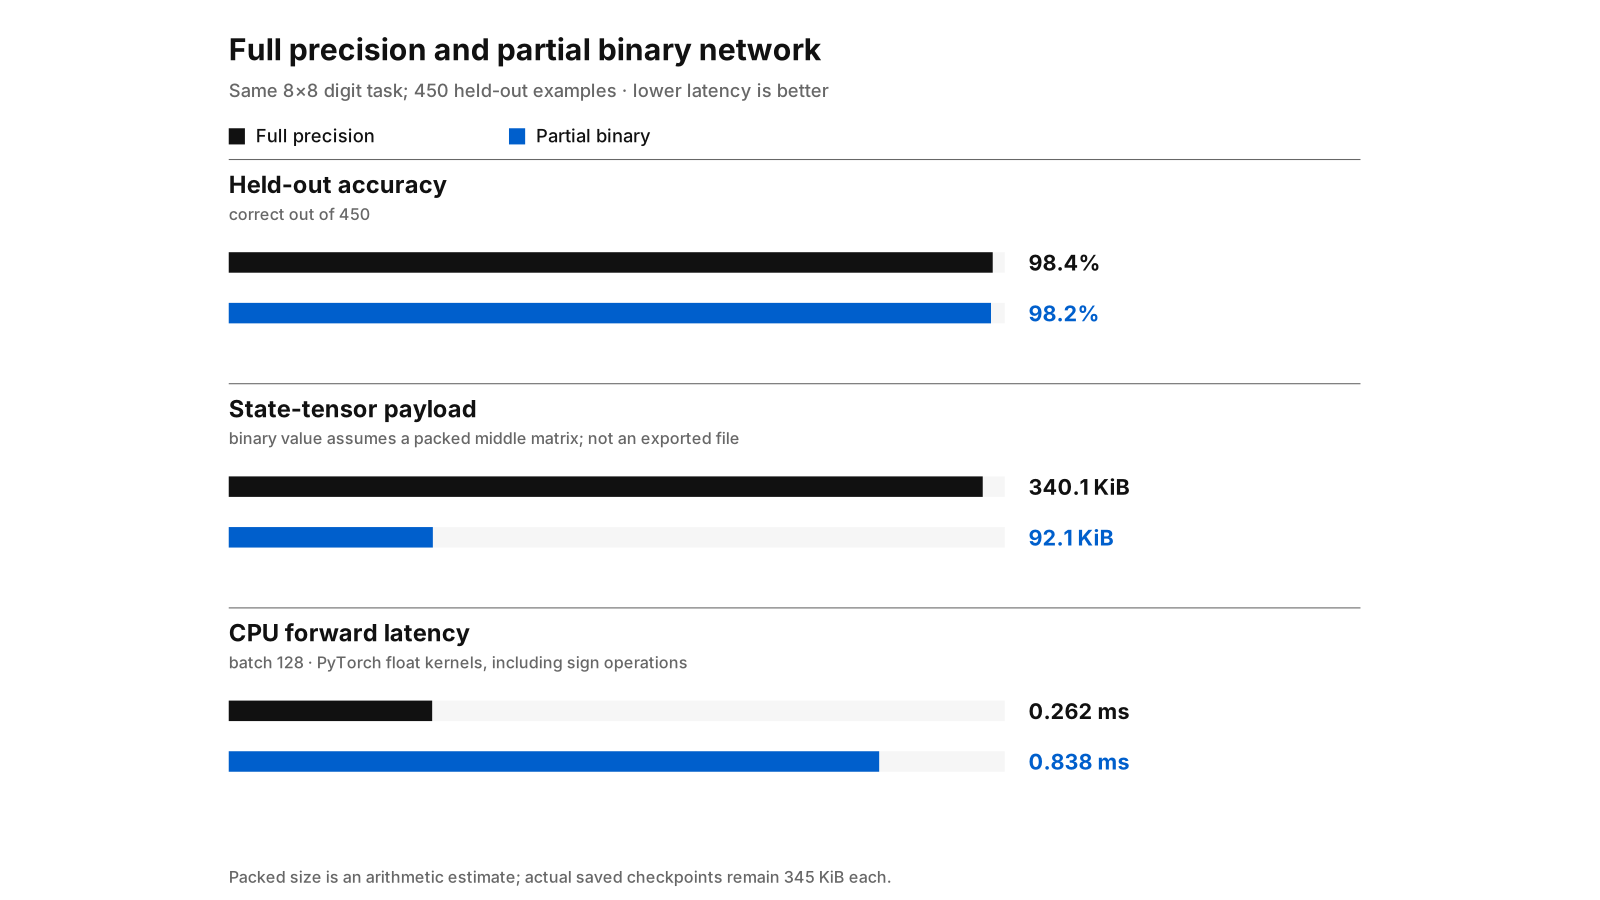
| 测试准确性 | 98.4% | 98.2% |
| 可训练参数 | 86,026 | 86,026 |
| 状态张量有效载荷,float32 | 340.1 KiB | 340.1 KiB |
| 如果中间权重是位打包的有效载荷 | 340.1 KiB | 92.1 KiB |
实际 torch.save 检查点 |
345.1 KiB | 345.1 KiB |
| CPU 前向,批次 1(中位数) | 0.0395 毫秒 | 0.1599 毫秒 |
| CPU 前向,批次 128(中位数) | 0.2621 毫秒 | 0.8381 毫秒 |
准确性仅相差一张保留图像。这对于该网络和数据集来说是令人鼓舞的,但样本太小,无法推断出普遍的准确性优势或稳定的 0.2 个百分点的损失。不同的分割、深度或任务可能会产生不同的结果。我们运行了一个种子,没有方差估计。
存储数据需要更仔细。我们统计了PyTorch状态字典中每个参数和缓冲区中的字节数。对于二进制网络, 计算的打包有效载荷,我们将其浮点中间矩阵的262,144字节替换为8,192字节:其65,536个条目中的每个条目一位。我们保持所有其他张量不变。由此产生的估计值从 348,216字节到94,264字节,一个 减少 72.9% 在这个狭义定义的数据包中。
我们没有创建或基准测试该打包模型文件。实验中没有自定义序列化器、位打包运行时、对齐计算或模型加载器。浮点影子权重仍然必须存储在训练检查点中。因此,实际的 torch.save 测量文件 353,331字节,实际上大小相同。将92.1 KiB的数字称为已实现的下载大小是错误的。
CPU 结果是重要的反例
二进制前向传递使用 torch.sign-等效值,由直通函数生成,然后是普通的 浮点矩阵乘法。它不调度XNOR或人口计数内核。因此,额外的操作会耗费时间,同时未能利用二进制算术的主要计算优势。
我们使用 PyTorch 2.10.0 和两个线程在 CPU 上测量了前向推理时间。每个数字是 40 次预热前向后,十组 200 次连续前向的中位数。输入已在内存中。我们不包括加载、图像预处理、磁盘读取或用户界面工作。
对于单个数字,部分二进制实现大约需要 4.0 倍 与全精度一样长:0.1599 毫秒对 0.0395 毫秒。在批量大小为 128 时,大约需要 3.2倍 时间更长:0.8381 毫秒对 0.2621 毫秒。这些是针对此特定 CPU、内核路径和短工作负载的测量结果。它们不是可移植的速度比率,并且每个都足够小,以至于主机调度和 Python 开销都很重要。结果仍然足以驳斥仅对权重进行二值化就使此实现更快的主张。
原文 XNOR-Net 研究区分了二值化表示和使用二值操作的执行。我们的代码只测试了表示和可以学习它的训练路径。为了测试所承诺的运行时效益,我们需要构建一个推理后端,该后端打包权重和兼容的激活,使用合适的位操作实现二值点积,并针对优化良好的浮点或 int8 基线测量端到端路径。
这对私人计算意味着什么
在笔记本电脑或台式机上进行计算可以减少将原始个人上下文发送到远程系统的需求。但是,设备上的模型会与其他工作争夺RAM、存储、内存带宽、电池和散热空间。因此,紧凑的表示形式值得测试,尤其是在始终可用的组件中,这些组件与大型AI工具一起执行分类或检索。
这项测试表明,一个小型网络可以容忍一个二进制内部层,而不会在简单数字上牺牲太多准确性。它确实 不 表示 Zortex 使用此网络,二值权重提高了模型的机密性,或者生成的模型适用于上下文引擎。隐私取决于数据放置、权限和披露控制。精度是独立的工程选择,可能有助于本地设计适应其资源预算。
数字中还有另一个限制: 92.1 KiB 仅在中间矩阵相对于全精度边界较大时才具有吸引力。一个模型的大部分参数都在未量化的嵌入或输出头中,则收益会较小。仅可训练参数的数量无法揭示可部署的混合精度文件将占用多少空间。
打包推理在运行时需要什么
部署性能取决于实际的位打包和专门的推理内核,并根据 int8 和 float32 基线进行评估。它将记录导出的文件大小、峰值驻留内存、跨批处理大小的挂钟延迟、如果可测量则记录功耗,以及在代表应用程序的任务上的准确性。用几个种子重复训练将量化效应与分割和优化器中的偶然变化分开。
脚本在 experiments/sec-binary/run.py 训练两个网络,计算正确的测试预测,测量状态字典负载和检查点字节,并计时推理。 results.json 保留测量的输出、计时方法、种子和软件版本。显示的图表直接读取这些结果。
这三个结果是不同的: 98.2% 的准确率,72.9% 的计算打包负载减少,以及更慢的测量 CPU 推理。存储估算不能替代紧凑的检查点或更快执行的模型。下一个决定是保存的内存是否足够大,以证明构建和维护优化的二进制运行时是合理的。