在此页面上
手写数字的 8 × 8 图像仅包含 64 个像素值。分类器可以识别保留集中的几乎所有示例,但仍然可以通过专门针对该分类器选择的方向更改这些值来使其失败。在我们的测试中,标准神经网络读取 450 个干净数字中正确识别 437 个。通过有界限的 20 步攻击,它读取了 相同的 450 个中正确识别 8 个.
在不增加模型容量的情况下,改变训练示例产生了最鲜明的对比。我们使用对抗性扰动示例训练了相同架构的第二个副本。在相同的攻击预算下,它识别了252个数字。干净准确率下降了四个正确分类的示例。这一改变在测试的攻击半径下恢复了准确率,但对干净输入造成了四个图像的成本。
这是一项关于对抗性的小型可重复研究 图片 分类。它不是Zortex产品基准或提示注入防御测试。
64 像素测试
我们使用了 scikit-learn 的数字数据集:1,797 张带标签的灰度图像,十个数字类别,以及介于 0 和 16 之间的整数像素值。代码将像素值除以 16,以便模型看到介于 0 和 1 之间的值。固定的分层 75/25 分割产生了 1,347 个训练示例和 450 个测试示例。测试图像从未包含在训练或模型选择中。
分类器有三个全连接层,维度为 64 → 128 → 64 → 10 和 ReLU 激活。我们使用相同的种子、层初始化、学习率、批量大小和分割,用 Adam 训练了两个版本 45 个 epoch。唯一计划的差异是训练期间呈现的输入:
- 标准训练: 使用未修改的训练数字。
- PGD 训练: 使用四个投影梯度步长和一个随机起点,将每个训练数字替换为针对模型当前权重生成的对抗版本。
训练攻击的L-无穷半径受限于 ε = 0.16。换句话说,64个归一化像素值中的任何一个最多可以移动0.16,结果必须保持在0到1之间。在原始的0-16像素尺度上,该限制对应于每像素2.56个单位。这在如此分辨率下是一个实质性的变化;我们不声称这些修改在视觉上是不可察觉的。
本实验测试了一个了解模型并能通过模型计算梯度的攻击者。攻击者更改了 输入,而不是模型权重或数字标签。该 FGSM 方法 在增加分类损失的梯度符号方向上迈出一步。 投影梯度下降 (PGD) 重复这些步骤,并将每个候选像素投射回允许的像素范围。为了评估,我们使用了 20 个 PGD 步骤,两次随机启动,并为每个测试图像保留了较高损失的候选像素。我们使用每个模型自己的梯度分别攻击每个模型。
什么幸存下来
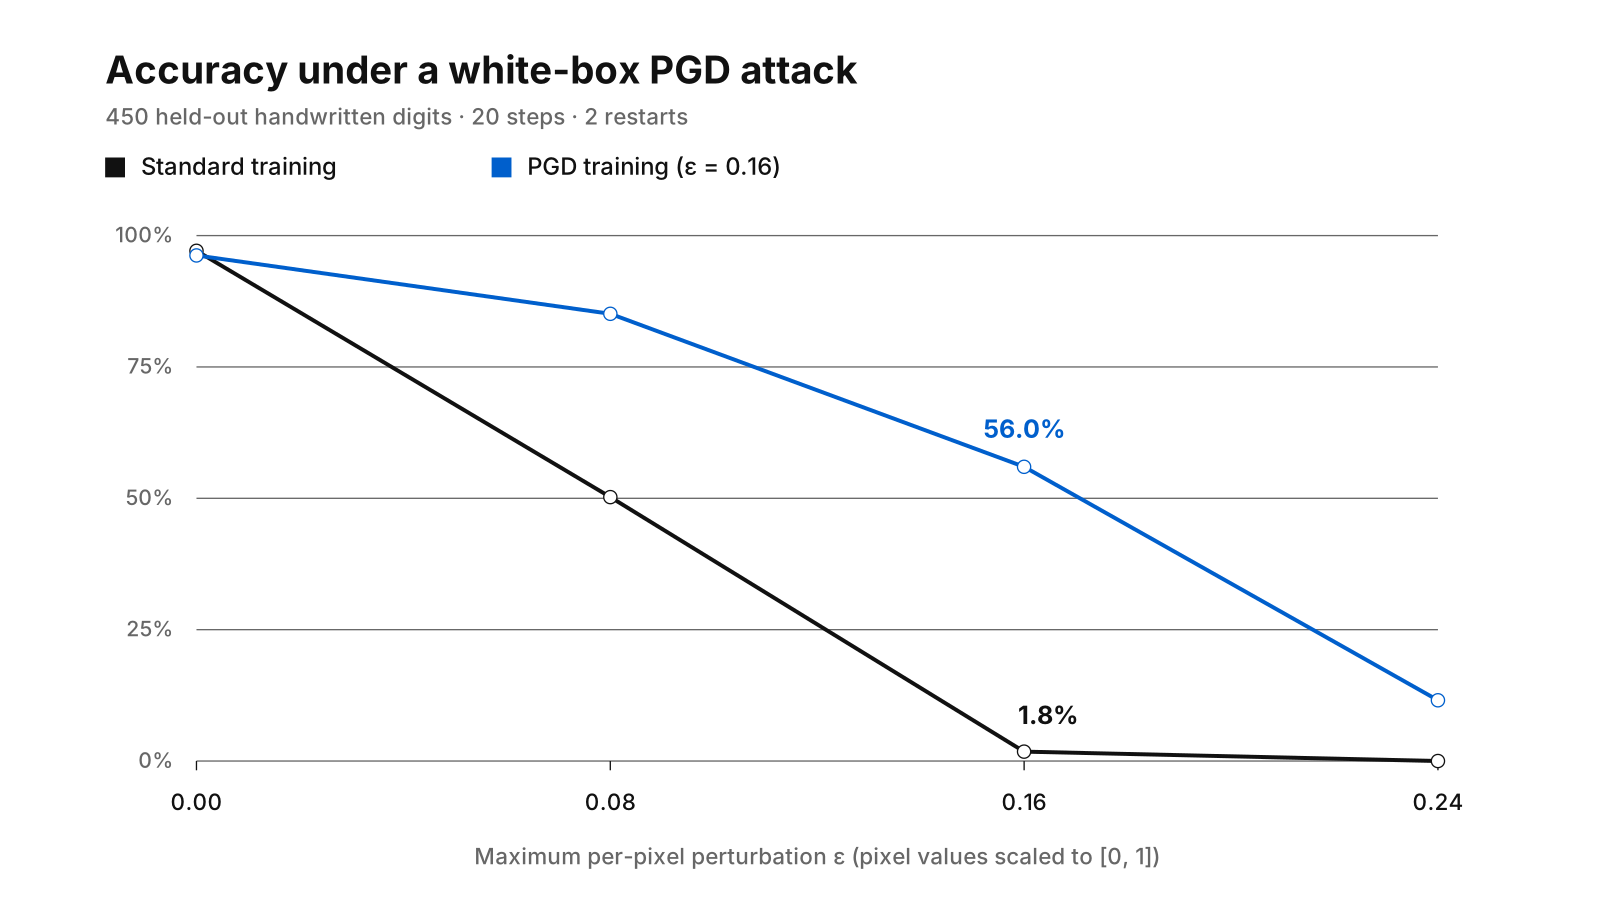
主要指标是 全部 450 攻击后正确分类的保留示例。它包括在扰动之前已经不正确的示例;它不是以干净预测正确为条件的攻击成功率。
| 评估 | 标准训练 | PGD 培训 |
|---|---|---|
| 干净,ε = 0 | 437/450 (97.1%) | 433/450 (96.2%) |
| FGSM,ε = 0.08 | 241/450 (53.6%) | 386/450 (85.8%) |
| PGD,ε = 0.08 | 226/450 (50.2%) | 383/450 (85.1%) |
| FGSM,ε = 0.16 | 19/450 (4.2%) | 274/450 (60.9%) |
| PGD,ε = 0.16 | 8/450 (1.8%) | 252/450 (56.0%) |
| PGD,ε = 0.24 | 0/450 (0.0%) | 52/450 (11.6%) |
仅凭干净的结果会产生误导。两个网络的准确率都达到了96%。在ε = 0.16时,普通模型的PGD准确率降至1.8%。通过对抗性输入进行训练将其提高到56.0%,差异为 54.2 个百分点 在此拆分。清洁准确度成本为 0.9 个百分点.
在相同的半径下,一步FGSM攻击使PGD训练网络的准确率达到60.9%,而更长的攻击下为56.0%。这种排序很重要。对一个梯度步骤看起来有效的防御可能仍然对一系列更小的步骤无效。在这里,迭代评估在两个网络中都发现了更多错误。
下一个半径暴露了第二个边界。在 ε = 0.24 时,防御模型的PGD准确率降至11.6%。针对一个扰动预算进行训练并不能在所有预算下提供保护。攻击者还可以选择不同的范数、目标或攻击家族。这些都没有在这里进行测试。
结果背后的故障模式
普通分类器学习的边界在干净数据集上表现良好。良好的平均分类与攻击者可以利用的方向上的狭窄边界是兼容的。攻击不需要随机采样损坏直到一个起作用。它使用损失梯度来定位破坏性方向,然后保持在声明的约束内。
对抗性训练改变了决定这些边界的示例。每个训练步骤都要求模型在选择使其失败的输入上表现良好。因此,我们测量中的改进是特定的:在测试半径下,在选择的白盒 FGSM 和 PGD 过程中,更多对抗性图像仍然被正确分类。
这既不是对网络内部特征的解释,也不是它们变得更像人类的证明。我们没有检查学习到的表示,也没有评估人们对数字的辨认能力。该实验记录了在定义的数学威胁模型下的行为。
这里存在一个方法论陷阱:如果防御者改变或掩盖梯度,普通的梯度攻击可能会失败,而分类器却未能变得可靠地鲁棒。我们使用了可微分前馈网络并直接攻击了防御模型,但两次PGD重启不能排除弱优化或所有形式的梯度掩盖。在提出安全声明之前,需要更强的自适应攻击、更多的重启和独立的攻击实现。
这与私人AI有何关联
Zortex 的工作涉及从个人应用程序中收集并经许可提供给 AI 工具的个人上下文。这种设置引入了其自身的安全问题:检索到的页面是否可以引导助手,内容是否跨越权限边界,以及工具操作是否获得授权。我们的数字分类器不模拟这些问题。像素扰动不是提示注入。
相关的教训在于评估的形式。“模型是准确的”是不够的,直到我们说出它对什么准确。 哪些输入和对手。同样,“上下文是私有的”需要根据声明的攻击者能力对存储、访问和披露进行操作测试。防御应该根据适应性尝试跨越其边界来判断,而不是根据最容易通过的情况来判断。
在本研究中,我们保持了整个管道的可检查性。代码在 experiments/sec-adversarial/run.py 加载数据集,训练两个网络,生成每次攻击,强制执行扰动约束,并将每个条件的计数写入 results.csv 和 results.json。上图是根据这些保存的计数生成的,而不是手动输入的。
攻击测试了什么
这些是来自一个分层分割和一个初始化的450张测试图像,而不是数据集或种子上的置信区间。8×8图像和小型多层感知器不能代表高分辨率视觉系统、语言模型或生产代理。L-无穷大攻击是一种方便的受控探测;它不代表所有现实攻击。我们没有进行认证鲁棒性分析、测试迁移攻击、搜索自适应故障或测量部署延迟和内存。
多个训练种子和独立的自适应攻击将测试此数字分类结果的稳定性。检索系统中的访问控制失败需要不同的攻击者模型和单独的实验。
狭窄的结果成立:一个在干净的8×8数字上几乎完美的模型,在有界白盒攻击下几乎全部失败。将其训练数据从干净的示例更改为对抗性示例,在训练半径下恢复了大部分准确性,但在更高的半径下留下了巨大且可测量的差距。