在此页面上
一个人在规划文档中可能会用官方名称称呼一个项目,在消息中用缩写,在日历事件中用旧的代码名称。这个人知道这些标签指的是同一项工作。只匹配问题中单词的搜索引擎可能不知道。
这是探索个人世界模型而不是将所有连接的应用程序记录视为一堆未分化文本的原因之一。但图表并非自动更好:它可能连接错误的人,传播过时的别名,或将不确定的关系转化为自信的搜索扩展。我们在可重现的生成收件箱记录集中隔离了已知项目别名的检索效果。
数据集和运行: 2026 年 10 月 9 日的测试使用了 120 个生成的收件箱式条目和 60 个定义的问题。它测量了排序器的前三名检索命中率。
问题
当用户询问一个项目的规范名称时,添加一个明确的、以前已知的项目别名是否能改善包含所请求批准记录的消息的检索?我们衡量的是检索,而不是可能从该消息中编写的自然语言解释的质量。
比较是在字面词汇搜索与从生成的项目目录提供的别名进行的相同词汇搜索之间进行的。别名是一个关系事实,而不是评估器在看到预期答案后发明的同义词。
设置
我们生成 30 个项目。每个项目有四个类似收件箱的条目:一条消息,其中包含最终批准的审阅者;一个目录条目,将规范名称连接到别名;以及两个合理的干扰项。总共有 120 个条目。
六个项目在审批消息中使用其规范标题。其他 24 个项目则使用别名。每个项目收到两个问题,总共 60 个。答案键是审批消息的 ID;仅找到目录链接不算数。有 12 个直接标题问题和 48 个仅别名问题。
基线通过 IDF 加权与问题的重叠来对整个集合进行排名。链接条件使用相同的分数、相同的语料库和相同的前三名截止,但将目录别名标记添加到查询中。两种条件都不使用嵌入或 AI 生成的重写。两者都故意简单,以便可以隔离额外关系的影响。
对于每个查询,命中意味着预期的批准记录在结果的前三名中的任何位置。我们保存所有前三名 ID、预期 ID 和按条件划分的结果 raw.json。实验不包含任何私人源数据,并使用固定的种子。
结果
| 问题子集 | 字面搜索 | 别名扩展搜索 | 总计 |
|---|---|---|---|
| 所有问题 | 45 | 60 | 60 |
| 直接标题问题 | 12 | 12 | 12 |
| 仅别名问题 | 33 | 48 | 48 |
所有问题图表是前三名中检索到的正确记录的数量,而不是准确生成答案的百分比。
Literal search | ██████████████████       45 / 60
Alias-expanded | ████████████████████████ 60 / 60
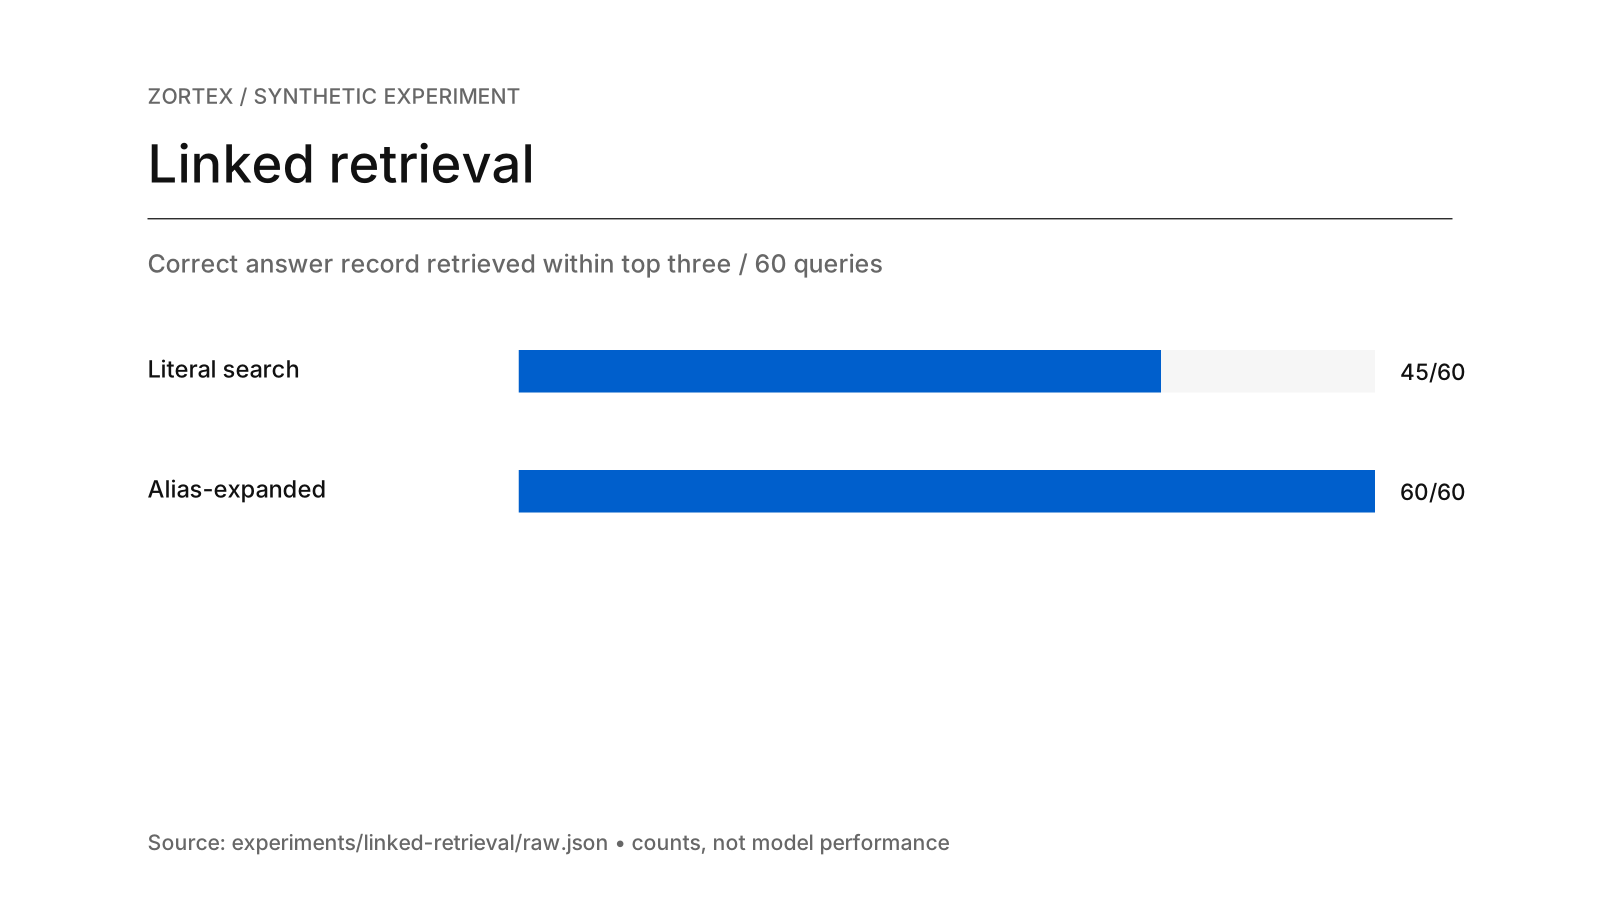
60 个生成问题的排名前三命中,有和没有已知别名查询扩展。
差异完全来自仅别名子集。在直接标题问题上,两种方法在每次试验中都检索到所需的记录。当批准消息使用另一个名称时,词汇排名有时会偏爱目录记录或带有规范标题的干扰。添加别名使批准记录在所有评估案例中都排在前三名。
目录映射提供了正确的项目别名,隔离了已建立关系对搜索的影响。有了这些链接,前三名的命中率从60个问题中的45个上升到60个。从嘈杂的收件箱内容中推断别名是一项单独的任务。
结果背后的决定
有用的设计理念并非每个搜索都应成为图搜索。而是关系应是可寻址、可检查的数据。如果用户已确认规划标题和收件箱标题指的是同一个项目,检索可以利用这种关系,而无需模型反复推断。
此类关系也应带有出处。哪条消息建立了别名?该名称上个月有效但今天无效吗?另一个项目现在使用相同的简称吗?一个无法回答这些问题的系统可能会将微小的召回增益变成难以调试的错误匹配。在个人上下文引擎中,错误的连接可能比错过低优先级结果更具破坏性,因为它们会污染提供给 AI 的证据。
该测试还建议为直接引用和间接引用分别记录指标。当许多简单的直接标题记录主导数据时,聚合分数可能会隐藏薄弱的别名处理路径。
测量范围
基线是一个小的 IDF 加权排序器,第二个条件将已知别名添加到相同的排序器。我们有意选择了一个小的 IDF 评分器。我们的语料库包含英文文本、短记录、干净的项目标识符,并且没有生成别名的竞争含义。评分衡量的是前三名包含,而不是排名位置、证据引用或获取目录映射所需的时间。
真实的全球模型还将具有不完整权限的帐户中的人员和项目连接起来。它可能不得不将别名视为有争议而非已验证。不正确的连接、变化的名称、多语言线程和重复的组织缩写可能会逆转结果。我们在此处没有注入这些困难。
循环中也没有语言模型。检索到的消息可能包含正确的字段,但模型可能回答不正确。高检索命中率只是准确响应的先决条件之一。
测试有争议的别名
故意让别名目录不完善:缺少链接、过时的名称、共享的首字母缩略词和对抗性近似匹配。比较直接文本搜索、确认链接扩展和不确定链接扩展。报告召回率和误报连接,包括每种失败将如何影响用户可见答案的示例。最后,在每个应用程序权限下重复测试,因为链接可能存在,但底层消息未授权给目标AI。
这 experiments/linked-retrieval/run.py 入口点和 raw.json 保留预期记录和每次查询的前三名结果。