在此页面上
大多数关于工作的问题都不是关于一份文档的问题。有人问谁将签署发布文件 和 当试运行开始时,需要的信息可能分散在电子邮件线程和日历条目之间。只找到其中一个的答案看起来相关但不完整。
Zortex 正在围绕一个人的工作私有模型构建,该模型由连接的应用程序组装而成,并根据个人选择的权限提供给 AI。第一个可衡量的任务是证据完整性:检索是否收集了问题所依赖的每条记录?
数据集和运行: 2026 年 10 月 9 日的运行使用生成的项目记录和确定性排序器。这些数字测量检索到的记录 ID。
问题
对于一组固定的生成工作问题,检索到的上下文量如何影响问题的比例,其中 全部 所需的证据是否存在?以及添加更多检索到的文本何时停止对这项特定任务有所帮助?
指标是 证据覆盖范围:检索到的集合中是否存在所需的源记录。模型可能会误解完整的源材料或遗漏决定性的限定条件。相反,一个人可能会根据所选记录中不存在的知识进行回答。我们的测试没有这些行为。
设置
生成器创建了24个项目,其标识符如下: arc07。每个项目有五条简短记录:一份签核邮件、一份演练日历备注、一份设计更新、一份站会备注和一份较旧的会议存档。最后三条是故意设置的合理干扰项。每个项目还有三种不同的问题表述,需要签核审查员 和 试运行日期。这产生了120条记录和72个已评估的问题。
一个小型、确定性的 IDF 加权词汇排序器根据每个问题对记录进行排序。它没有嵌入、模型调用、长期记忆或学习偏好。对于每个词预算,我们按顺序获取排序后的记录,不将记录截断,并计算已检索到的两个所需记录 ID 的数量。六个预算分别是零、35、70、140、280 和 560 个以空格分隔的词。
所有夹具均由固定种子制造。答案键包含每个问题的两个记录 ID,而不是猜测的自然语言答案。记录 ID 匹配使评分可重现,但也使其比真实世界中验证段落是否真正支持某个主张要容易得多。
结果
该表显示了完整的证据覆盖率和找到至少一个所需记录的较低要求条件。
| 上下文预算 | 两份记录 | 至少一个 | 问题 |
|---|---|---|---|
| 0 个单词 | 0 | 0 | 72 |
| 35字 | 0 | 72 | 72 |
| 70 字 | 24 | 72 | 72 |
| 140字 | 72 | 72 | 72 |
| 280字 | 72 | 72 | 72 |
| 560 字 | 72 | 72 | 72 |
一个紧凑的图表 完成 案例使该步骤可见。规模止于72个问题。
  0 words |                         0 / 72
 35 words |                         0 / 72
 70 words | ████████               24 / 72
140 words | ████████████████████████ 72 / 72
280 words | ████████████████████████ 72 / 72
560 words | ████████████████████████ 72 / 72
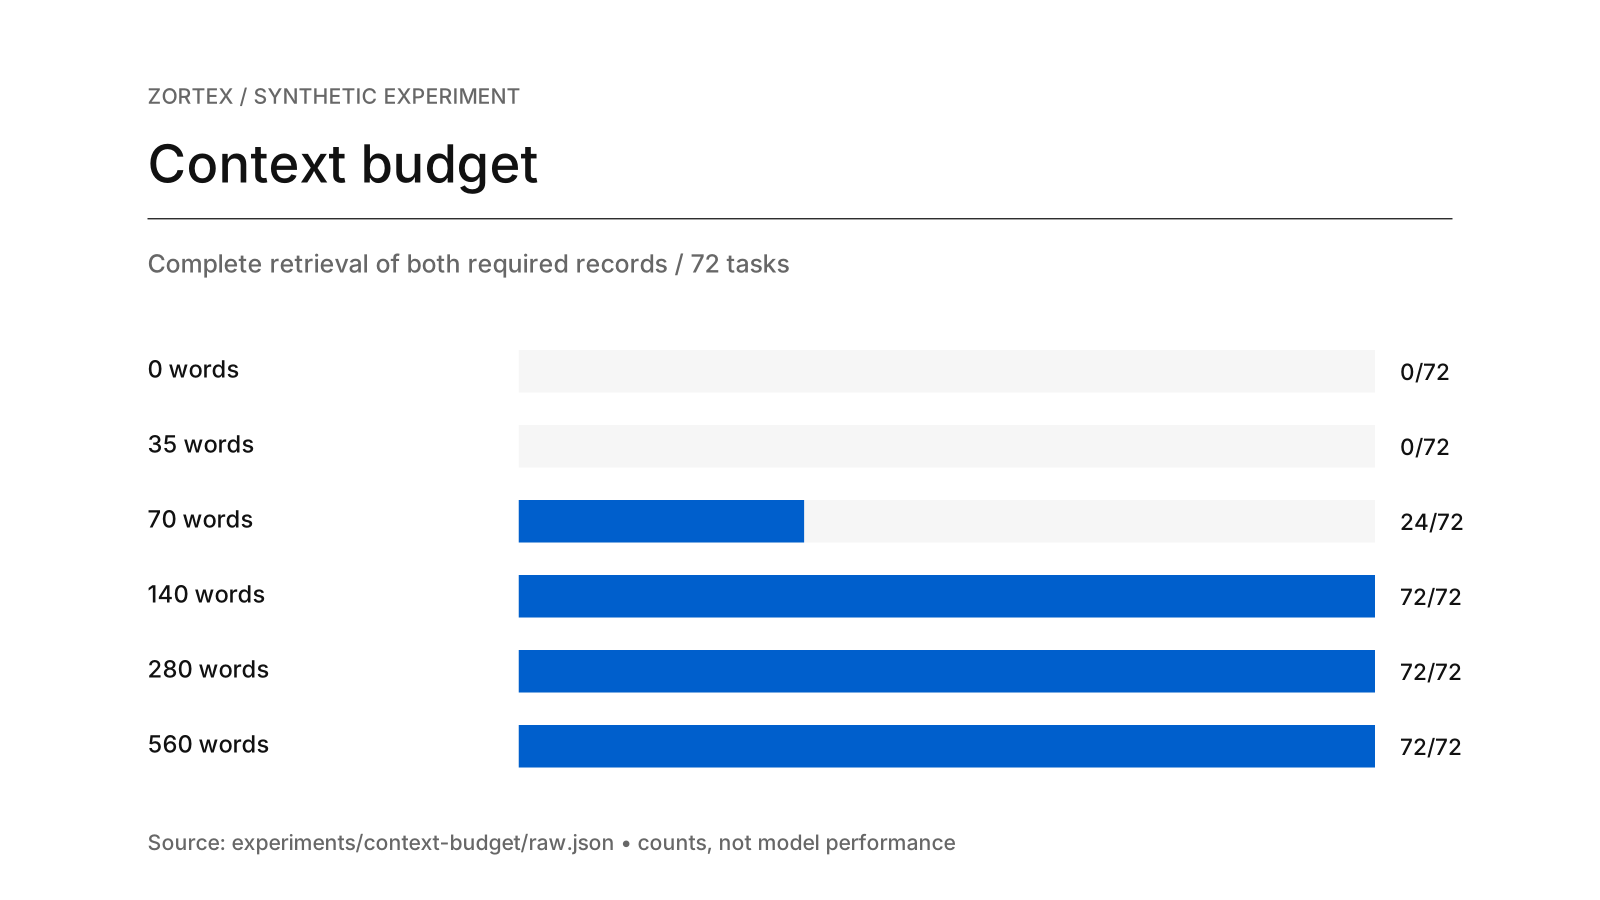
针对 72 个生成的两记录问题,在六个检索预算下评分的完整证据计数。
在 35 个词的限制下,每个问题都有一些支持,但没有一个足以满足两个记录的答案键。这是核心警告:看起来相关的搜索结果不一定足够。在 70 个词的限制下,三分之一的问题包含两个记录。测试夹具在 140 个词的限制下达到完全覆盖,接下来的两个预算没有增加成功率。
对于此语料库、这些问题和此排名器,平台在 140 个词处出现。结果为测量的任务提供了具体的预算阈值。在更大的收件箱中,排名器可能会将几个不相关的笔记放在前面;在实际任务中,事实可能隐藏在附件、修订或引用的历史记录中。如果引入冲突或过时的信息,更多的上下文甚至可能使模型推理变得更糟。我们没有测试任何这些影响。
这对设计意味着什么
上下文构建器应该询问任务的证据是否 完成,而不是简单地是否检索到高分记录。这种区别表明应单独跟踪答案要求:审阅者、日期、决定、所有者、文档版本和类似槽位。如果系统检索到审阅者但没有日期,它应该再次搜索或呈现空白,而不是默默地暗示确定性。
它还建议将上下文预算视为需要优化的约束,而不是填满整个窗口的邀请。当记录关系清晰时,完整集可能很小。缺失的需求可能通过有针对性的后续检索而不是另一大块不相关的消息更好地解决。
私有世界模型方法增加了一个单独的问题:正确的文档可能存在,但未授权当前询问的 AI 访问。因此,必须衡量证据覆盖范围 之后 权限过滤,而不是假设每个连接的记录都可以传递给每个模型。
测量范围
本次运行刻意避免使用 AI 模型,因此无法确定答案何时停止听起来通用。它无法衡量基础性、引用准确性、连贯性、隐私或用户满意度。词汇评分、项目标识符、记录长度和词汇预算都在代码中公开;不同的语料库可能会大幅移动表观阈值。
这些示例使用整洁、简短的英文记录。它们没有附件、同一线程中混合的语言、已删除的消息、时间戳争议或相互矛盾的事实。通过/失败标准还假设预先识别了正确的证据。真实的个人搜索很少有完美的答案。
检索缺失的第二个事实
配对的后续测试使用更长、更混乱的生成历史。一个条件应使用固定的检索上下文;另一个条件应在答案要求仍然缺失时再次检索。然后要求真实模型在两种条件下回答,并独立评估其引用、遗漏和无根据的主张。包括额外检索的成本,并对两组应用相同的权限边界。
为了重现性,请参阅 experiments/context-budget/run.py 和配套的 raw.json 在该目录中。生成器的逻辑位于 experiments/run.py。原始文件记录了每个问题和预算的排名和涵盖的金记录数量,因此可以独立重新计算该表。