在此页面上
同步引擎一天中的大部分时间可能都在询问是否发生了什么。考虑每五分钟检查六个连接的账户。即使没有文件移动,也没有会议更改,这个计划在一个 30 天的月份中也会产生 51,840 个请求。这个数字不是 Zortex 的测量值。它是每小时六次十二次检查,乘以 24 小时,乘以 30 天。它告诉我们,在任何人向 AI 提问之前,一个选择不当的刷新策略会产生什么样的账单。
个人世界模型必须保持足够新颖才能有用。它还需要在授权过期、事件遗漏、文件删除和笔记本电脑休眠后继续存在。我们将请求计数和存储大小放在三个同步选项旁边,以揭示它们的不同成本。
六个连接器,三个刷新计划
我们的模型有六个独立刷新的来源,一个人,一个 30 天的月份,以及每次刷新一个结果页面。我们比较了三种策略。频繁轮询每五分钟检查每个来源。每小时轮询每小时检查一次。事件驱动策略在一个月内收到 2,400 个模拟更改通知,并对每个来源执行一次夜间追赶检查:6 × 30,即 180 次检查。每个通知都算作一个单独的 API 调用。我们排除了重试、订阅续订、分页、初始导入和速率限制退避。
| 刷新策略 | 30 天内通话次数 | 相对计数 |
|---|---|---|
| 五分钟轮询 | 51,840 | ████████████████████ |
| 每小时轮询 | 4,320 | ██ |
| 事件支持加夜间检查 | 2,580 | █ |
每个块大约代表 2,600 次调用。比例是近似的;在所述假设下,计数是精确的。 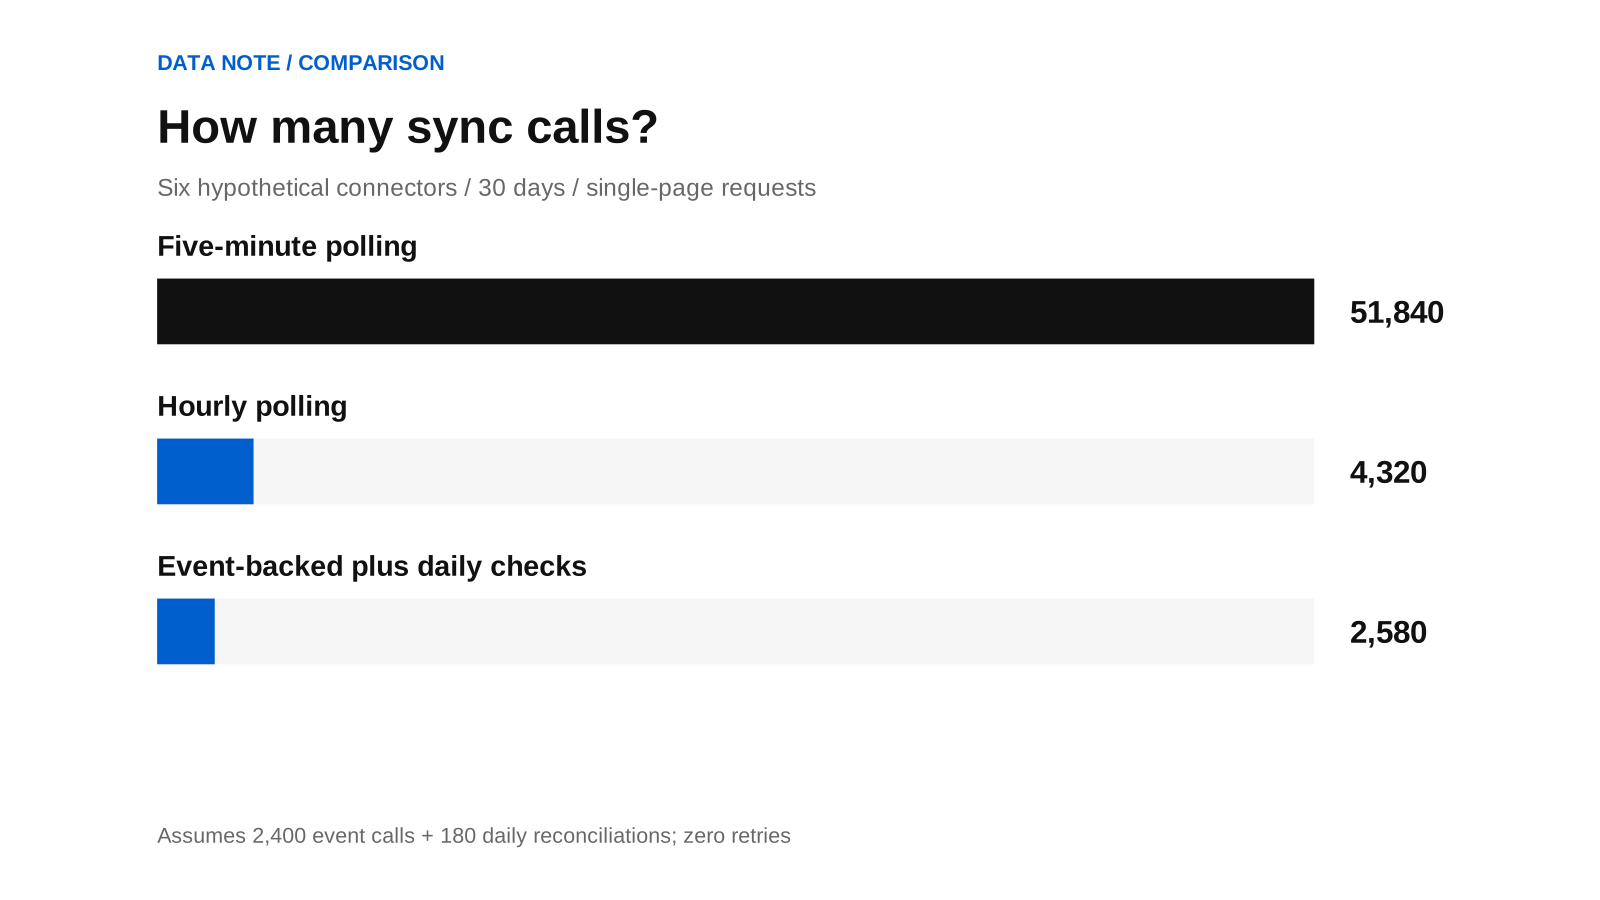
图:在三个明确的同步假设下,建模的每月连接器请求计数。.
事件支持的计数取决于更改密度。通知可能以突发形式到达、重复或需要后续获取才能发现更改了什么。Google Drive的 更改API 使用保存的页面令牌检索更改的文件;监视通知表示有内容需要检查,而不是提供更改的文件本身。Microsoft 的 图增量 API 使用延续链接和增量链接跟踪邮件文件夹中的添加、更新和删除。Gmail 的 推送通知文档 表示邮箱监视必须至少每七天续订一次。监视是一种持续的订阅,而不是神奇的免费同步。
在我们刻意简化的模型下,事件计划有 180 个固定的协调调用,加上每个通知更改的一个调用。每小时轮询有 4,320 个调用,无论发生多少更改,只要每个响应保持一页。计数在每月 4,140 个事件调用处相遇。低于该点,基于事件的计划发出较少的请求;高于该点,每个事件一个调用的实现发出更多的请求。
| 每月因变更触发的调用次数 | 活动计划总计 | 每小时计划总计 |
|---|---|---|
| 0 | 180 | 4,320 |
| 2,400 | 2,580 | 4,320 |
| 4,140 | 4,320 | 4,320 |
| 6,000 | 6,180 | 4,320 |
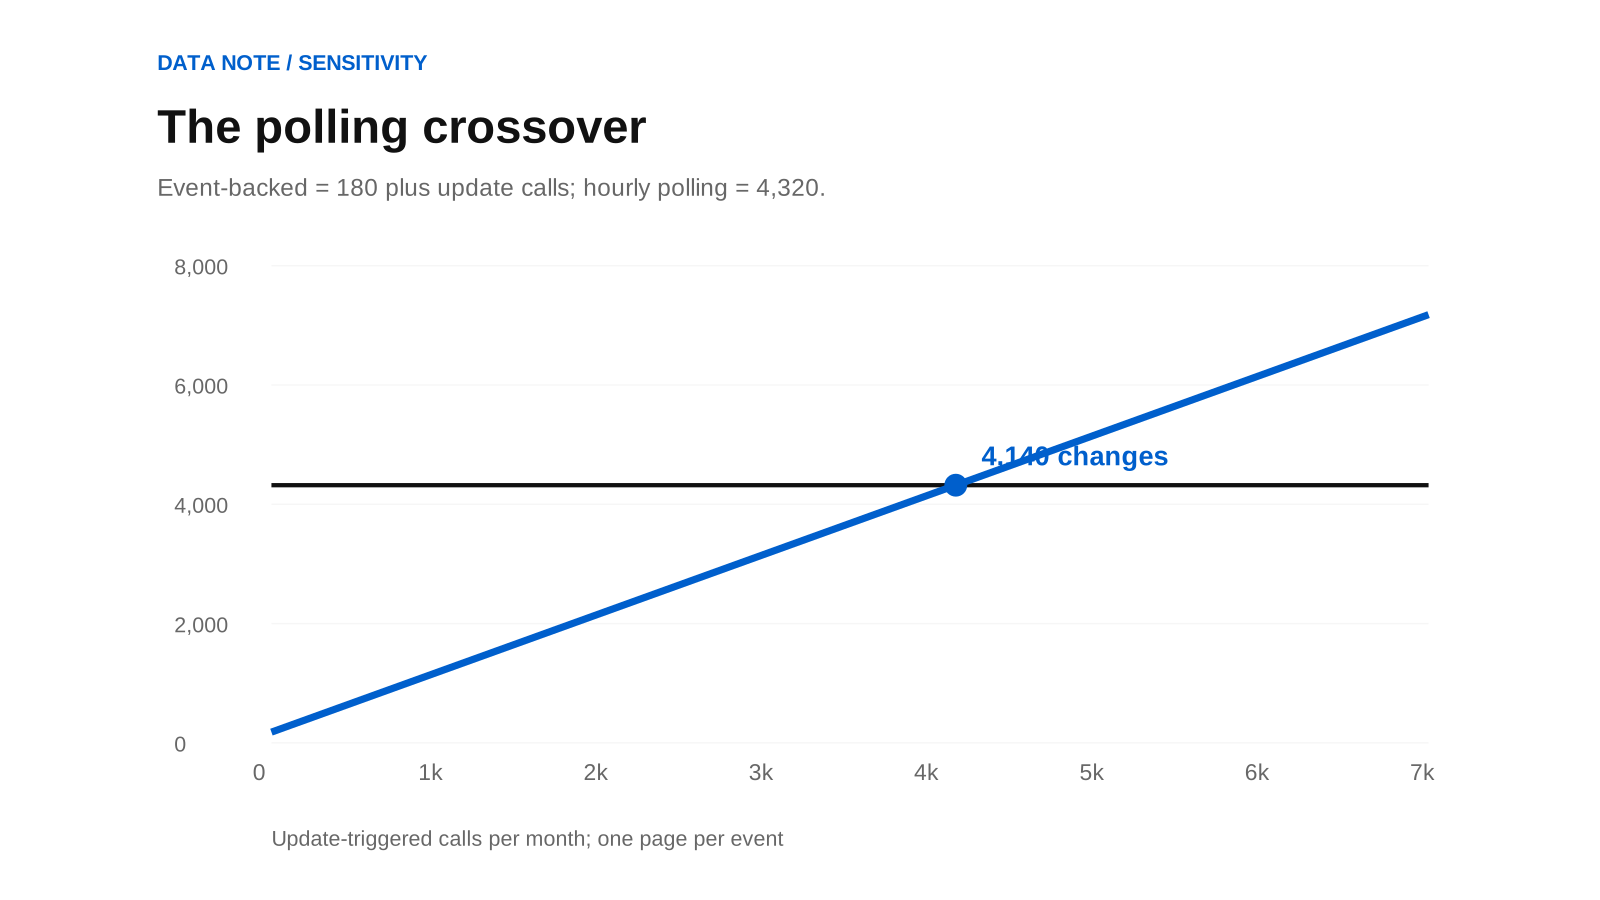
图:每小时轮询和事件支持同步之间 API 调用中建模的交叉。。实际提供商通常将多个更改合并为一个增量获取,或将繁忙的结果分页为许多调用。真正的连接器根据测量的更改密度、允许的陈旧性、提供商配额以及恢复错过通知的能力来选择策略。该表隔离了一个权衡;它不基准测试三个正在发货的连接器实现。
链接背后的字节
现在假设一个个人索引包含30,000个轻量级项目记录,平均1,500字节,100,000个关系记录,每个80字节,以及每个项目一个768维的float32向量。这些假设大约给出45 MB的项目元数据,8 MB的关系和92 MB的原始向量:在搜索索引、数据库页面、加密开销或备份之前大约145 MB。
将该数字翻倍作为索引和维护的粗略估算,将使这个建模状态达到约 290 MB。存储 5 GB 的原始文件或附件将完全改变存储情况。相关的设计决策是世界模型是否需要原始内容的副本、带有源指针的最小表示,还是可配置的混合。无论是 5 GB 缓存还是 290 MB 索引都不是测量的 Zortex 占用空间。
初始导入是另一类工作。一次性读取30,000个对象与在一个月内有2,400个对象发生变化时维护它们不同。如果每个更改的项目需要一个新的400个令牌表示,那么每月嵌入工作量为960,000个输入令牌。如果只更改了时间戳,则可能不需要重新嵌入。如果一条消息更改了它所属的项目,那么更新两个图边缘可能比再次嵌入该消息更有用。过时或未经授权的条目需要失效,而不仅仅是另一次检索。
这些区别还可以防止误导性的总金额。API 请求并非以一个统一价格计费;配额、范围和付费层级取决于提供商。嵌入价格取决于模型和部署。磁盘、备份、同步带宽和 CPU 时间在用户计算机和托管服务中具有不同的成本。诚实的用户成本模型必须将每个测量量乘以其实际单位费率,然后包括错误、闲置容量和支持。我们在此处建模的是工作负载计数,而不是生产发票。
本地优先真正改变了什么
产品描述于 Zortex 早期访问页面 从一个人的应用程序构建一个私人工作模型,在本地运行时将其保存在他们的计算机上,并让他们决定连接的 AI 可以看到什么。还有一种可选的云模式,用于在设备关闭时获取上下文。这些是产品承诺,而不是我们数值工作负载所确定的发现。
本地优先设计改变了谁存储和处理工作状态。它可以避免保留个人工作的另一个完整的集中副本,并将索引工作转移到已拥有的机器上。它不会使CPU周期、电力、存储磨损或备份免费。它也不会免除连接器处理授权过期或源删除的责任:私有索引仍然可能是私有错误的。
对于工程审查,我们因此会在发布任何每用户成本数据之前记录五个计数器:按连接器和响应类型划分的源请求;更改的字节;重新计算的记录和边;表示令牌或本地推理时间;以及从源更改到正确可搜索状态之间的时间。第六个衡量标准,即在失效后仍可检索的已删除或已撤销记录,是安全要求而非效率指标。
模型的重点很窄。询问变化有时比处理变化更昂贵,刷新策略甚至在模型推理开始之前就可以主导请求计数。当工作负载移动时,交叉点也会移动。能够解释该边界的工程师在选择本地索引、事件交付和定期协调方面比同步廉价的平坦承诺有更好的基础。
重现工作负载计算
两图均包含 几何封面图,由 图表来源。六源、30 天的数据是根据所述工作负载假设计算的。提供商行为来自链接的 Google 和 Microsoft 文档;源脚本重新生成了这两个数字。