在此页面上
助手无需了解提问者太多信息即可回答问题。一个记住项目、阅读电子邮件、连接到工作应用程序并代表个人行事的助手处理的信息量不同。有些信息来自提示。有些信息来自文件、连接的帐户、活动记录和以前的对话。有些信息成为助手再次使用的上下文。
OpenAI发布的文档详细描述了这些流程。它们还描述了不同类型的控制。停止模型训练与删除对话不同。断开服务与删除代理从中学习到的内容不同。关闭内存不会擦除原始材料。随着ChatGPT从回答请求转向跟上一个人的工作,这些区别变得很重要。
本分析使用 OpenAI 的 隐私政策 (更新日期 2026年9月10日), 使用条款 (生效日期 2026 年 1 月 1 日),以及 服务条款 (更新日期 2026年9月29日),以及下面链接的产品特定文档。所有内容均已审核 2026年10月9日。欧洲经济区、英国和瑞士的读者有单独的 欧洲隐私政策 (更新日期 2026年8月24日)和 欧洲使用条款 (更新日期 2026 年 1 月 16 日);企业客户有单独的协议。条款可能因地区而异:例如,美国和欧洲的政策对某些披露类别进行了不同的分组。账户行为取决于适用的地区、计划和设置。
记录始于记忆之前
这 隐私政策,第 1 节,包括账户详情和支付历史、提示、上传的文档、图片、音频和视频,以及 “来自连接服务的数据”。它还列出了用户选择连接的联系信息、与OpenAI的通信以及来自其他来源的信息。
有些信息无需输入对话即可到达。该政策涵盖 IP 地址、浏览器和设备特征、交互日志、使用的功能、采取的操作、时区以及从网络信息推断出的粗略位置。个人可以选择提供精确的设备位置。对于免费和 Go 帐户,该文档描述了有关查看或参与的广告数据;它还涉及来自广告商和数据合作伙伴的信息。范围超出了个人记得告诉模型的内容。
收集并不意味着每个项目都用于每个目的。政策规定信息支持运行服务、个性化、研发、安全、法律合规、通信以及在特定情况下的营销和广告。这些目的应与训练和个性化的具体控制措施一并阅读。
这 使用条款,内容部分,将所有权与处理分开。它说 “您 (a) 保留您在输入中的所有权” 并将 OpenAI 在符合条件的输出中的权利分配给用户。同一部分写道 “我们可能会使用内容来提供、维护、开发和改进我们的服务”。拥有提示或答案并不意味着它只保留在用户设备上,或者提供商无法处理它。
信息可以持续存在的四个地方
对于普通对话, 聊天和文件保留指南 表示常规聊天和存档聊天会保留在帐户中,直到删除或适用的工作区规则将其删除。存档会更改聊天的显示位置,而不是其保留期限。删除聊天会立即将其从帐户视图中删除,并安排在 30 天内永久删除,除非信息已被去标识并与帐户分离,或者安全和法律义务要求更长的保留期限。该 隐私政策的保留部分 同样表示通常会删除 “30天内” 并规定了例外情况,包括欺诈、合规性、支付记录和删除请求的审计记录。
临时聊天有另一个规则。 数据控制指南 表示它不进入历史记录,不创建或更新内存,并且在临时期间不用于改进模型。OpenAI 可能会出于安全目的保留副本长达 30 天。较新的控件允许临时对话在用户选择个性化临时聊天时利用现有上下文。保存的临时对话会变成常规对话。临时描述的是对话的处理方式,而不是绝对禁止使用先前的上下文。
文件可以是一个单独的保留对象。OpenAI 的 保留指南 声明: “删除聊天不会删除仍保存在图库中的文件。” GPT 和项目中的文件有其自己的删除触发器。删除讨论文档的对话不会删除所有保存的副本。
内存是另一个层面。在 ChatGPT 中的内存,OpenAI 将过去的聊天、保存的记忆、自定义指令、库文件和连接的应用程序列为潜在的个性化来源。较新的记忆摘要 “不一定包括所有细节或来源” 可以为响应提供信息。它是一个审查界面,而不是一个完整的清单。
完全移除的说明比关闭开关更严格。同样的指南警告: “单独删除聊天不一定会删除单独保存的记忆”。一个人可能需要删除内存、原始和存档对话、库文件以及其他来源;连接的帐户可能需要断开连接。关闭内存会停止普通的个性化设置,但会保留过去的聊天记录。OpenAI还描述了有限上下文的单独安全用途。它可能会保留已删除的保存内存日志长达30天。
点使边界更容易看到
OpenAI 于2026年9月29日推出点阵。一个点是一个始终在线的代理,拥有云计算能力、访问授权插件的权限,以及在交互之间继续工作的能力。OpenAI描述了向符合条件的Pro、Business Premium和Enterprise用户进行的初步推广。这是一个产品功能,而不是ChatGPT旧内存设置的另一个名称。
这 点隐私、安全和保障常见问题 表示插件权限在 dots、ChatGPT、ChatGPT Work 和 Codex 之间共享。一个 dot 可以在已授予的范围内使用现有连接。它还可以从 ChatGPT 接收记忆和最近的对话上下文,其对话可以为 ChatGPT 记忆做出贡献。连接工作应用程序以进行一个工作流的人员应该了解哪些其他授权界面可以使用该连接。
常见问题解答称点上下文可以持久存在 “只要您保留您的点”。它可能包括来自对话和插件的信息,尽管OpenAI表示上下文不保留凭据、图像或屏幕截图。单个点内存目前无法查看、删除或直接编辑。删除点会删除其自身的上下文,但单独保存的ChatGPT对话、Codex线程和文件不会自动消失。
两个控件具有特别狭窄的效果。关闭 ChatGPT 内存会停止与点的共享;常见问题解答说 “它不会删除您的点已收到的信息。” 断开插件会停止通过该连接进行的新访问,而不是之前从中构建的语境。删除点、清除 ChatGPT 记忆、删除生成的文件以及断开应用程序可以解决问题的不同部分。
当信息被收集时,点也会发生变化。主动研究可以读取允许的来源,并在另一个请求之前保留私人笔记。OpenAI 表示,这些研究工具不能直接发送消息、修改连接的服务或控制计算机或浏览器;后续操作遵循批准规则。安全检查、自定义规则和操作审查是相关的保护措施。 服务条款,第14节,仍然说 “您应对他们采取的行动负责” 代表您。当代理活跃而其所有者不在时,监督仍然很重要。
模型改进是一个单独的开关
这 隐私政策,第 2 节,表示用户内容可能被使用 “训练为 ChatGPT 提供支持的模型”。对于个人ChatGPT账户, 数据控制指南 指定退出: “您的新对话将不会用于训练 OpenAI 模型” 当“为所有人改进模型”关闭时。现有已保存的聊天记录将保留。关闭训练不会关闭回答请求、删除数据或自动禁用内存所需的处理。
这 点常见问题 将相同的设置扩展到个人计划中符合条件的点工作:对话、操作、委托工作、自动化以及引入这些任务的连接应用程序信息可能涉及其中。它表示不会使用主动背景研究及其笔记 直接 用于训练,但后来引入到符合条件的任务中的信息可以。OpenAI 表示,即使在模型改进被禁用后,为了安全,仍可能进行一些人工审查。
连接的 Google 服务具有资格。OpenAI 的 Google 应用数据控制常见问题 说 “我们不会使用来自连接的 Google 应用的数据直接训练我们的通用模型”,但有明确的例外:反馈提交、手动复制或上传到对话中,以及ChatGPT响应中包含的材料。这些例外和点状指南应一并阅读,而不是用“所有连接信息都用于训练”或“没有任何信息可以进入训练”的笼统说法来取代其中任何一个。
这 数据控制指南 表示 OpenAI 默认情况下不会在 ChatGPT Business、Enterprise、Edu 和 Healthcare 工作区内容上进行训练。不同的业务协议、管理员控制和保留设置适用。计划、来源、操作和设置都会影响问题的答案:此数据是否用于训练模型?
还有哪些其他方参与?
这 隐私政策,第 3 节,命名为 “供应商、服务提供商和营销合作伙伴”。它描述了托管、云基础设施、支持、安全、支付、分析、通信服务、搜索和购物提供商以及选定的营销合作伙伴,具有不同的角色和限制。它还描述了关联公司;法律和安全披露;公司交易;以及企业账户管理员的访问权限。这些是已披露的类别,而不是每个合作伙伴都收到每个用户对话的证据。
广告的区别应该保持精确。OpenAI 说它做到了 不 向广告商出售用户数据或向广告商提供其私人对话。其 广告原则 状态 “我们绝不会将您的数据出售给广告商”。该保证与广告个性化处理以及政策向某些营销合作伙伴披露有限信息并存。这些不是相同类型的共享。
连接的应用程序添加了自己的边界。 服务条款,第7节,表示ChatGPT可以将相关内容和一些位置信息发送到连接的应用程序。OpenAI补充道: “我们不对提供给应用程序后的应用程序数据负责”,除了它拥有的应用程序。接收方的条款管辖那里的信息。向OpenAI发出的删除请求本身并不能指示每个外部服务删除它已收到的记录。行动的目的地与授权它的设置同样重要。
信息流向何处
该地图区分了保留对话、个性化上下文、培训资格和第三方交换的文档化路径。它们的使用取决于账户设置和任务。
Prompts / files / activity / connected apps
                    |
                    v
            OpenAI services
                    |
       +------------+-------------+
       |            |             |
       v            v             v
 Chat history    Memory          Dots
 & Library       summary      agent context
       |            |             |
       |            +-------> future answers
       |                          |
       +--------------------------+
                    |
             eligible tasks
                    |
             model improvement
             (account setting)

 Other possible flows from services:
   -> service providers / affiliates
   -> external apps and actions (their policies)
   -> legal and safety disclosures
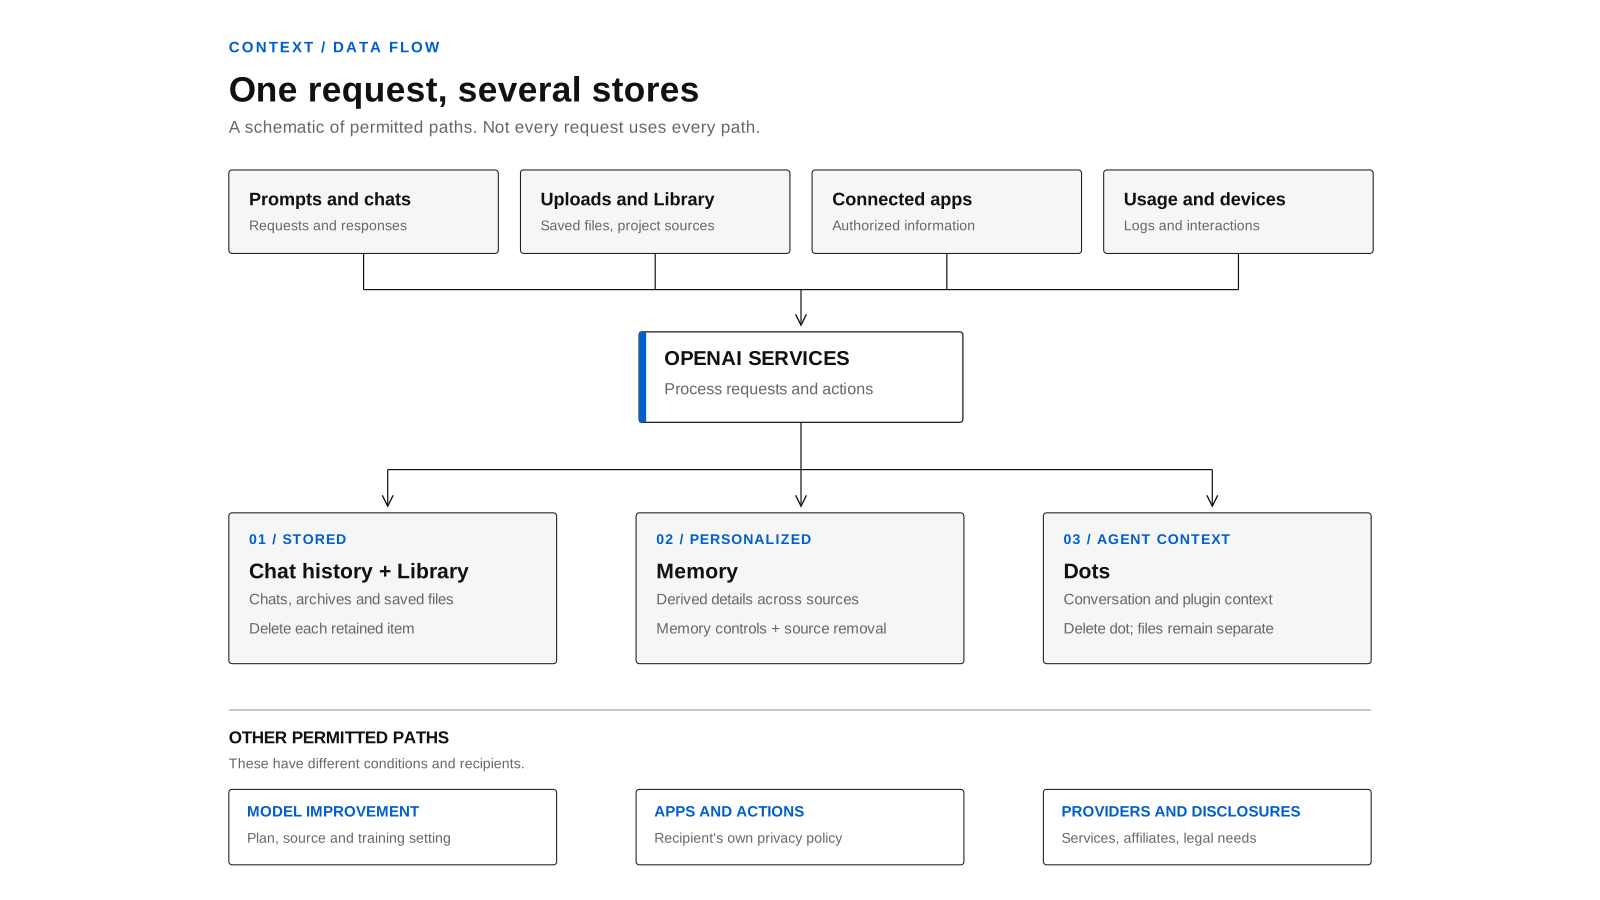
图表:对话历史、记忆、点语境和外部目的地具有独立的保留和删除路径。
重要的比较
| 问题 | 2026年10月记录的ChatGPT | 隐私优先的个人上下文设计 |
|---|---|---|
| 上下文存在于何处? | 聊天、图书馆、记住的上下文和点上下文可以是托管服务中不同的存储。 | 用户控制的本地索引是主要记录;任何云副本都有明确的角色。 |
| 什么进入答案? | 符合条件的既往聊天、文件、记忆、已连接应用和代理上下文,受控。 | 为每个请求选择上下文,并附有可见的来源列表和明确的接收者。 |
| 它能训练一个通用模型吗? | 取决于计划、设置、工作流程和特定于源的规则。 | 个人上下文作为系统属性被排除在通用模型训练之外。 |
| 断开连接时会发生什么? | 新插件访问停止;之前保留的内存或点上下文可能仍然存在。 | 访问权限被撤销,并且可以识别和删除派生上下文。 |
| 可以删除一个记忆吗? | ChatGPT提供记忆控制;目前无法编辑或删除单个点记忆。 | 每个存储的项目和派生断言都是可检查、可纠正和可擦除的。 |
| 删除涵盖了什么? | 聊天、图书馆文件、记忆、点和第三方接收者有不同的处理流程。 | 一个删除请求遵循数据血缘并报告外部异常。 |
第二列总结了已发布的行为,而不是关于OpenAI实施的安全发现。第三列描述了隐私优先产品可以做出的架构选择;它们并非自动源于本地存储。
隐私优先的产品会改变什么
隐私优先的助手将从较小的传输开始,而不是更复杂的设置页面。它将在个人控制底层数据的地方构建其个人工作模型,然后仅披露特定答案或操作所需的上下文。准备回复所需的电子邮件线程不必自动成为该人以后使用的每个工具都可以访问的持久内存。
它将使记忆中的事实可追溯。这个人可以看到来源,哪个模型或工具接收了它,它是否被复制到另一个存储中,以及它何时过期。更正将改变保留的表示,而不仅仅是要求模型避免提及旧的表示。撤销连接器将暴露一个关于已经从该连接器派生的上下文的决定,而不仅仅是停止检索。
训练将有一个固定的边界:私人上下文永远不会通过不相关的交互或反馈流成为通用模型训练材料。云执行在需要时仍然可用,但其角色、保留窗口和第三方接收者在传输前将可见。加密将保护存储和传输的材料;它不会取代对谁处理明文的答案。
本地优先系统还处理设备可用性、备份、同步、丢失的密钥和检索成本。第三方操作仍然会将信息发送到个人控制之外。任何系统都无法仅仅通过擦除自己的历史记录来撤回已发送的电子邮件或撤销购买。一个严肃的隐私设计会区分它可以删除的内容和它只能撤销、请求或披露的内容。
OpenAI的文档描述了真实的控制和保护措施,尤其是在训练偏好、临时聊天、工作区策略和代理批准方面。它们还展示了一个有用的助手可能在多少地方保留上下文。这样一个系统在不被再次询问的情况下能做的工作越多,了解一个人的生活哪一部分保留在哪个存储中——以及哪个删除实际上能触及它——就变得越重要。