在此页面上
一条消息提到了一个人。一个日历事件包含相同的地址。一个文档使用一个简称讨论一个项目。这些记录是相关的,但搜索索引不一定知道如何关联。
Zortex 的方法是保留源记录及其含义的决策。源是证据;模型是对该证据的解释。当名称冲突、身份改变或早期推断被证明是错误时,这种差异很重要。
此处描述的组件在 ZortexHQ/try-indra。它们包括事件日志、身份解析器、派生声明、索引和图服务外观。每个推断的关系都保留了证据链和纠正路径。
最初的观察先出现
这 事件日志实现 描述了仅追加事件段作为权威记录,并附带可重建的 SQLite 表示和 blob 存储。连接器将类型化源事件发送到此边界。事件日志是刻意机械化的;它不需要语言模型来决定是否应保留上游观察。
假设两封电子邮件提及同一个会议,并且一个文件包含议程。一个诱人的设计是编写一个单一的精美摘要,然后只保留该摘要。当会议更改或摘要受到质疑时,问题就出现了:如果没有原始身份和修订,系统无法解释哪个观察支持了哪个句子。
事件记录和引用它的派生允许系统重新审视该决定。
这也是为什么源时间戳和系统观察不能互换的原因。迟到的事件可以描述更早发生的事情。摄取顺序告诉我们系统何时遇到证据;它并不总是告诉我们现实世界的事实何时变为真。
解析名称是决策,而不是字符串连接
这 解析器 获取包含提及、来源和证据标识符的事件视图。其阶段包括规范化、候选生成、评分和身份决策事件。
对于电子邮件地址,规范化可以使精确的句柄匹配有意义。对于常见的显示名称,则不能。名称本身是弱证据:两个人可以共享它,一个人可以使用多个句柄。因此,解析器区分观察到的提及和由几次观察形成的实体集群。
该代码还维护负面身份证据:断言两个引用不同的记录。用户建立的区别是自动化解析不允许随意覆盖的边界。模糊情况有审查路径,而不是强制性的推测性合并。
这些约束与“快乐路径”同样重要。错误的合并可能会使后续检索的错误更加自信,因为不相关的证据被收集在一个标签下。
各层如何连接
Source records and revisions
             |
             v
     Append-only event log
             |
             v
     Mentions and evidence
             |
             v
   Identity resolution decisions
             |
       +-----+------+
       |            |
       v            v
  Entity cards   Evidence-linked claims
       |            |
       +------+-----+
              |
              v
    Index / graph projections
              |
              v
       Bounded graph view
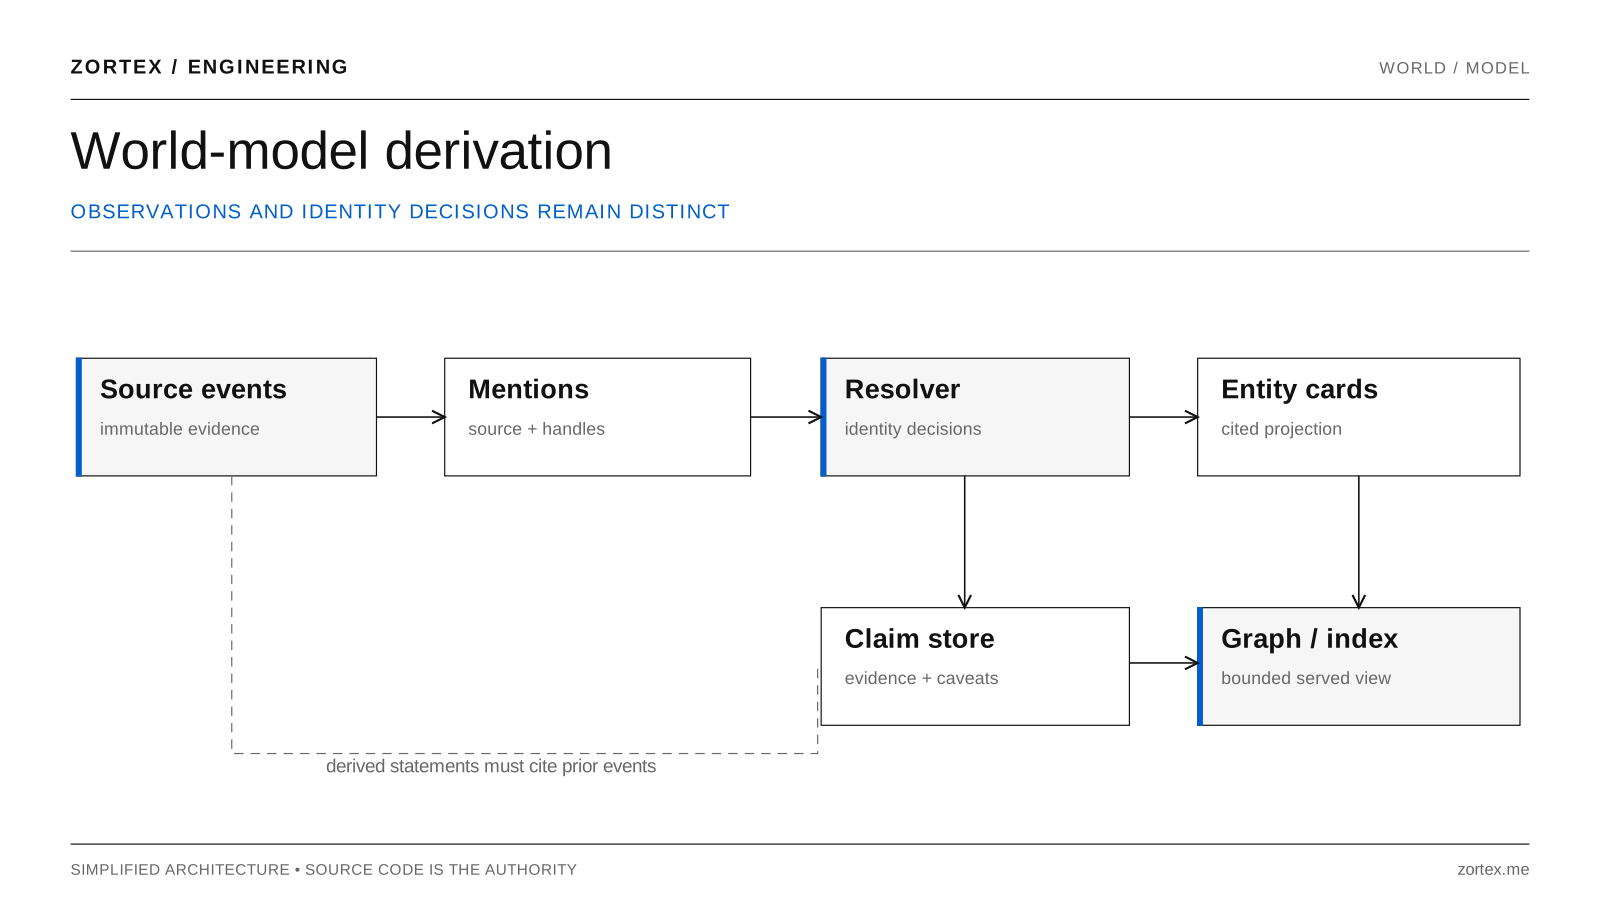
图表:事件记录、身份决策、声明和图投影。
这 图投影代码 将身份决策折叠到实体中,并渲染描述这些实体的卡片。它的 测试 检查重播相同的决策日志是否产生相同的投影,以及实体卡的知识声明是否带有引用。
这种可重建性是故意的。图是一种检查一组已解析关系的方式;它不应成为一个独立的真理来源,其出处已被遗忘。
声明需要有自己的生命周期
身份可能是正确的,但关于它的断言可能不正确。某人确实可能是同事,但说明他们拥有某个项目的笔记可能已经过时。
这 声明层 在接受派生知识声明之前检查证据标识符。它实现添加、失效和替换,而不是原地编辑旧断言。它还使相互矛盾的声明及其出处可见,而不是让一个默默地擦除另一个。
一个明确的保护措施涉及不完整覆盖:低覆盖率的声明必须附带警告。这是一条代码中的规则,而不是断言系统总能衡量它是否已读取所有有意义的来源。
第二个防护措施保护用户声明的断言免受自动失效。自动结论可能与用户的声明不符,但分歧不足以删除它。该冲突仍可供检查和纠正。
这就是存储合理句子和保留可追溯证据链的系统之间的区别。
图必须能够表明它已过时
图视图也是一个工程预算问题。 GraphFacade 强制执行视口响应中节点和边的上限。它读取已提交的布局位置,而不是将未完成的布局状态视为有效。如果布局不可用,它可以报告带有陈旧指示的未定位节点,而不是凭空创建坐标。
相邻的 索引测试 检查有界图导出是否报告截断,以及没有文档的索引是否产生已检查的空状态。禁用的子系统或缺失的投影不应与没有历史记录的人无法区分。
这些经过测试的服务规则限制了响应大小,并区分了缺失的投影和空结果。
文档、人员和项目背景
在日常语言中,世界模型连接人、项目和文档。从技术上讲,这些并非都是同一种对象。
源文档具有稳定的上游引用和修订。人们可能需要跨多个地址和句柄进行身份解析。一个项目可能表现为一个短语、一个声明、一个文件夹或一个文档集合;审查过的解析器代码并不能证明每个项目都自动创建为具有完美边界的一等实体。
Zortex 实现了从观察到的记录到引用的实体和声明预测的路径,并与其索引记录一起提供。
纠正关系
别名、共享账户、转发消息、缺失来源和矛盾陈述是常见的,而非例外。最具破坏性的失败往往是根据不完整的证据做出的自信合并。
每段关系都需要三个答案: 它从何而来?什么证据可以改变它?更正后能否重建预测? Zortex 单独保留源事件、解决决策和索赔修订,因此一个人可以追溯与证据的关系,并在更正后重新审视。
视觉来源: 代码生成的封面研究.